La fiecare câteva zile, o pereche de sateliți europeni fotografiază întreaga suprafață terestră a planetei. Aceștia se numesc Sentinel-2; orbitează la aproximativ 786 de kilometri altitudine și văd lumea în culori pe care ochii noștri nu le pot percepe — infraroșu apropiat, marginea roșie, benzi de unde scurte care dezvăluie cât de viguros crește o pădure sau cât de umed este un câmp. Datele sunt gratuite, deschise și există o cantitate aproape absurdă de informații.
Problema este că „o grămadă enormă de imagini satelitare gratuite” nu este același lucru cu „ceva din care o mașină poate învăța”. Imaginile brute sunt doar numere. Pentru a antrena modele care recunosc culturile, cartografiază orașele, detectează defrișările sau descriu un peisaj în limbaj simplu, aveți nevoie ca aceste imagini să fie tăiate, curățate, etichetate și împărțite în seturi de antrenament și testare.
Acest decalaj este motivul pentru care am petrecut o mare parte din anul trecut dezvoltând SENSERO în colaborare cu colegii mei de la laboratorul GeoSense
Ce este de fapt SENSERO
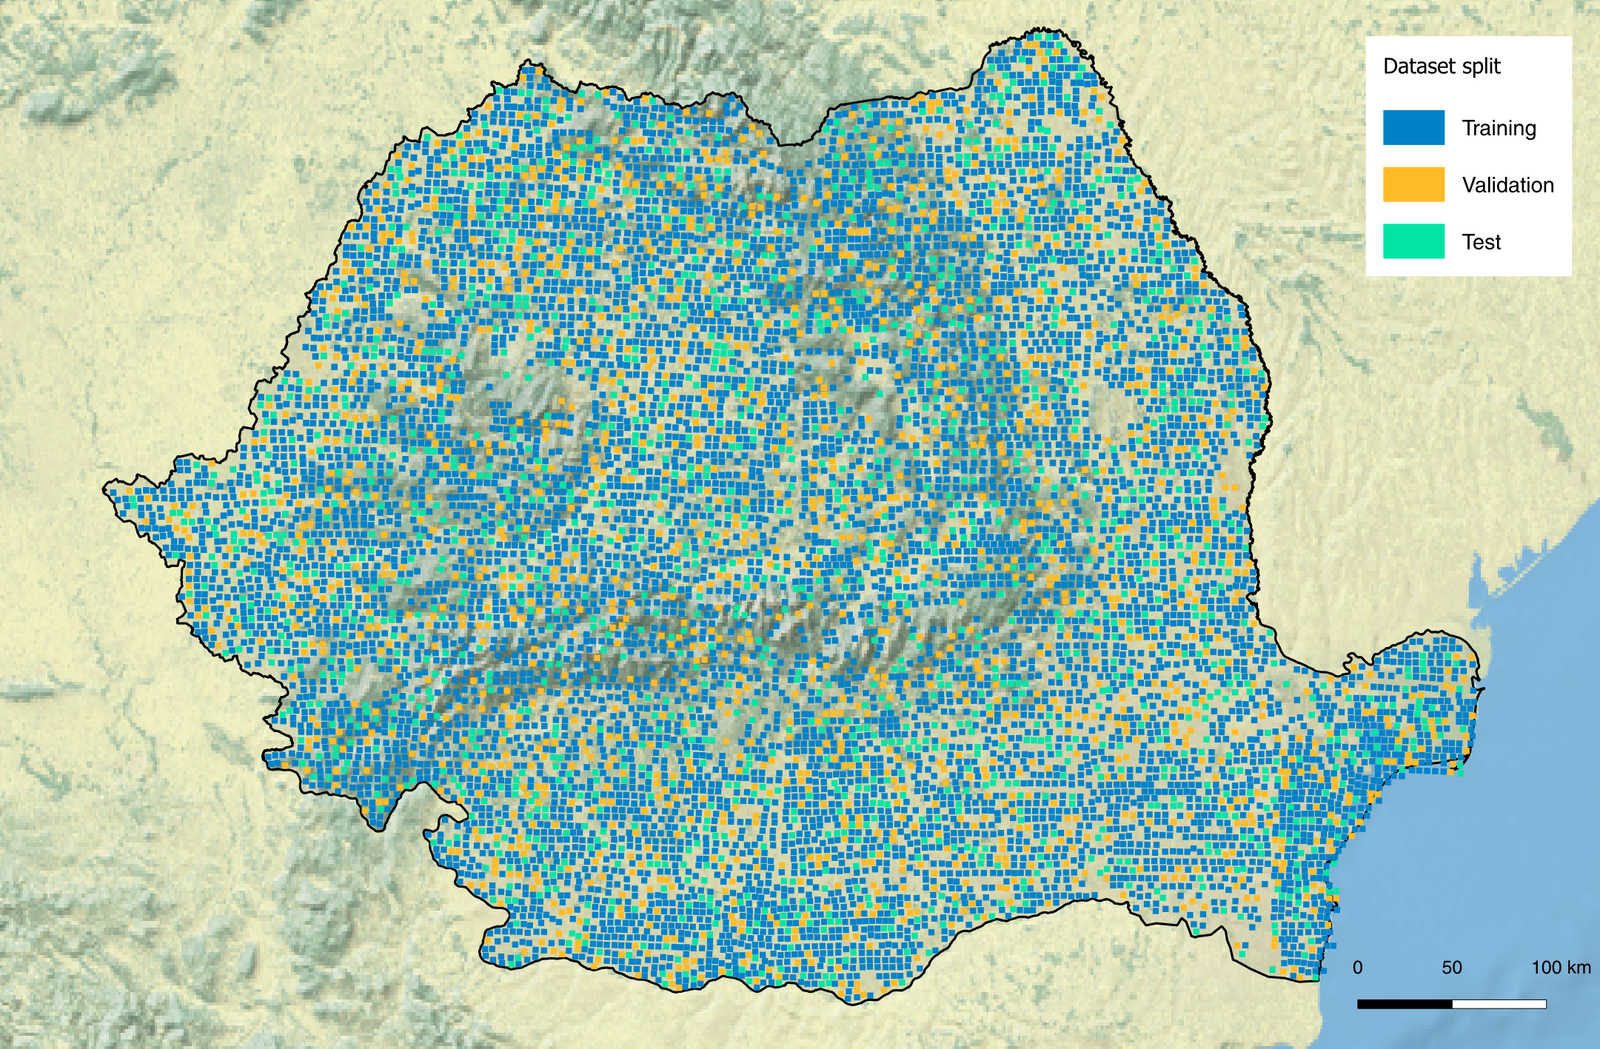
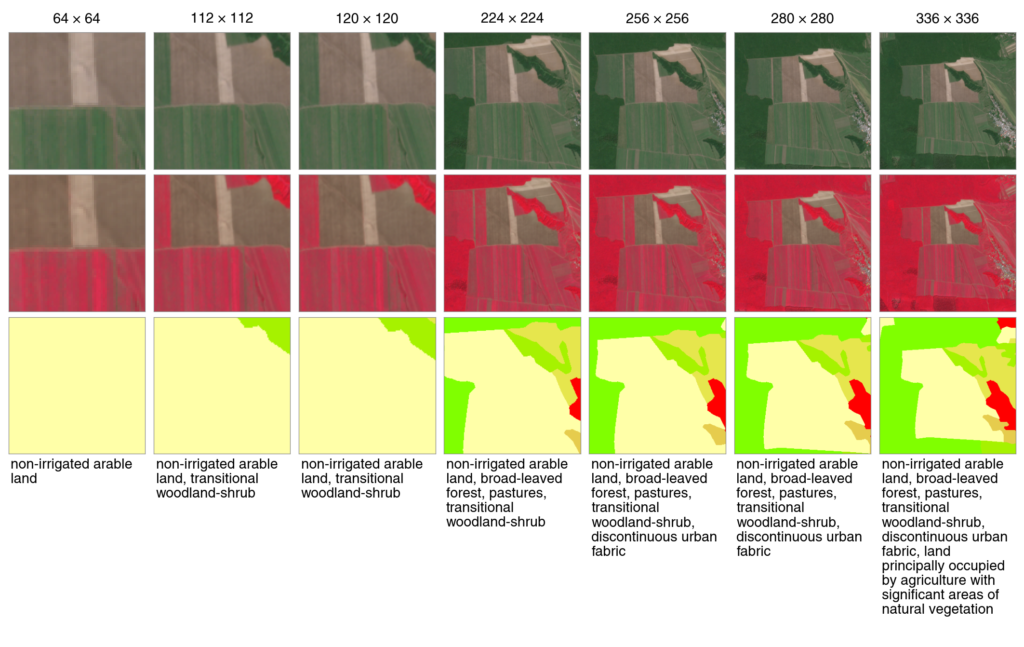
SENSERO este un set de date cu exact 10.000 de locații din România, extrase din imagini Sentinel-2. Ceea ce îl diferențiază de alte seturi de date de teledetecție este o decizie de proiectare: în loc să fixeze o singură dimensiune a zonei de studiu, așa cum fac aproape toate celelalte seturi de date, acesta oferă fiecare locație la opt dimensiuni diferite, de la un prim-plan strâns de 64×64 pixeli (aproximativ 0,4 km lățime) până la o vedere largă de 336×336 pixeli (aproximativ 3,4 km), toate având același centru. Întregul scop este de a aborda o întrebare pe care domeniul o trece de obicei cu vederea — cât de mare ar trebui să fie de fapt o zonă? Așadar, setul de date nu vă arată doar 10.000 de locuri; vă arată fiecare loc prin opt ferestre de lățime crescândă. Aceasta înseamnă 80.000 de imagini etichetate.
Și sunt etichetate. Fiecare fragment, la fiecare dimensiune, poartă cinci descrieri paralele a ceea ce conține: trei niveluri ale ierarhiei standard europene de acoperire a terenului — de la câteva categorii largi până la aproximativ treizeci și patru de categorii fine — plus două vocabulare alternative, cel utilizat de setul de date BigEarthNet, larg citat, și o schemă pe care am adaptat-o peisajului românesc. Etichetele nu sunt scrise manual; ele sunt generate determinist dintr-o hartă autoritară de acoperire a terenului, astfel încât fiecare poate fi urmărită până la sursa sa.
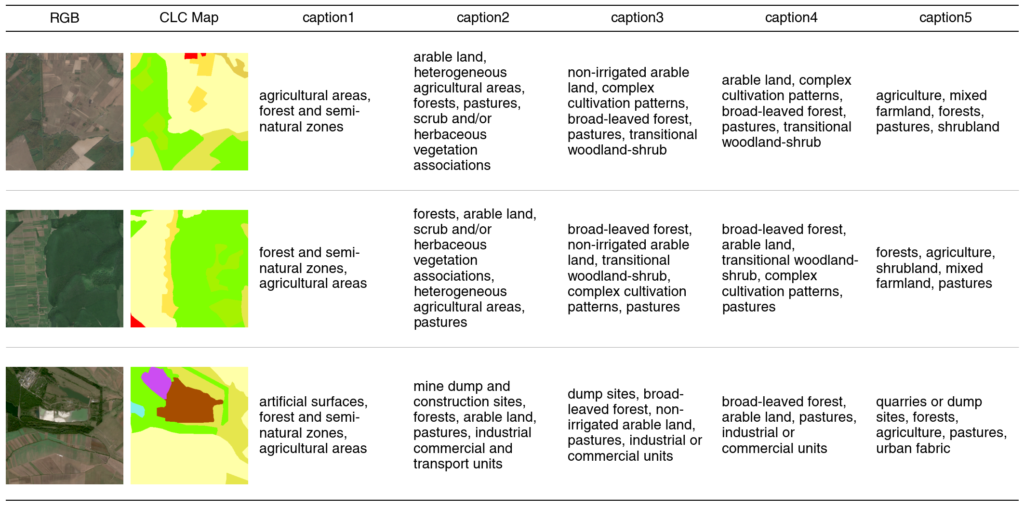
Aceste etichete sunt scrise ca liste simple, separate prin virgulă, și acest lucru este deliberat, deoarece ocolește o alegere pe care majoritatea seturilor de date v-o impun. Majoritatea seturilor de date clasice de teledetecție vă oferă o imagine și o singură clasă — „pădure”, „apă”, „urban” — ceea ce se potrivește unui clasificator tradițional de învățare automată, dar aplatizează orice altceva. Noile seturi de date viziune-limbaj vă oferă subtitrări în text liber, ideale pentru modelele pe care le puteți interoga în limbaj simplu — „arătați-mi fragmente cu un râu care traversează teren agricol” — dar incomode pentru a alimenta un clasificator simplu. Etichetele SENSERO se află în ambele lumi simultan: citiți șirul ca o frază și aveți o subtitrare pentru un model viziune-limbaj; împărțiți-l după virgule și aveți o listă cu etichete multiple pentru învățarea automată clasică. Același set de date le servește pe amândouă, fără reformatare — și o face la fiecare dintre cele opt scări.
Câteva alte aspecte îl fac mai mult decât simple „imagini cu text atașat”:
- O fereastră de achiziție aleasă deliberat. Fiecare zonă provine dintr-o perioadă de nouă săptămâni la sfârșitul verii 2018 (9 august – 14 octombrie). Acest lucru nu este arbitrar: este o fereastră îngustă cu acoperire redusă de nori, fără îngheț sau zăpadă și o stare fenologică stabilă — astfel încât un câmp de grâu arată ca un câmp de grâu în întregul set de date, în loc ca o imagine să arate sol gol și alta plină de vegetație. Consistența aici elimină în mod discret o întreagă categorie de zgomot care altfel ar crea probleme modelelor.
- Divizări ce țin cont de geografie. Seturile de antrenament, validare și testare sunt separate după locație, mai degrabă decât amestecate aleatoriu. Niciun fragment nu se suprapune la nicio scară, și am impus, de asemenea, o distanță minimă între fragmentele de antrenament și cele de testare — deoarece bucățile de teren din apropiere tind să arate similar (un efect numit autocorelare spațială), iar fără acest decalaj un model poate părea bun pur și simplu fiind testat lângă locuri pe care le-a văzut deja în antrenament. Așadar, este măsurat cu adevărat pe teren pe care nu l-a văzut niciodată. (Distanțele exacte și puținele excepții inevitabile sunt documentate integral în lucrarea însoțitoare.)
De ce „o singură dimensiune a zonei” este o presupunere adesea ignorată
Aproape fiecare set de date de teledetecție ia o decizie tacită și apoi nu o mai revizuiește niciodată: alege o singură dimensiune a zonei. EuroSAT taie lumea în plăci de 64×64 pixeli, BigEarthNet în 120×120, iar de atunci fiecare model antrenat pe ele vede peisajul prin acea fereastră fixă — și numai prin aceea.
Dar dimensiunea nu este o chestiune tehnică; în geografie, face parte din semnificație. O fereastră de 200 de metri ar putea surprinde un singur câmp; o fereastră de un kilometru surprinde locul acelui câmp într-un mozaic de parcele, drumuri și un râu. Măriți, și vedeți textura; micșorați, și vedeți contextul. Unui model căruia i se oferă doar una dintre acestea i se spune în mod tacit că cealaltă nu contează.
Ceea ce este surprinzător este cât de puțin știm de fapt despre care fereastră este cea potrivită. Întrebarea — cât de mult modifică dimensiunea fragmentului ceea ce învață un model? — a fost abordată doar în experimente izolate, unice, care tind să nu fie de acord: unele raportează o creștere a preciziei pe măsură ce fragmentele cresc, altele constată că fragmentele mai mari estompează tocmai detaliul care a făcut ca clasificarea să funcționeze. Motivul este structural. Dimensiunea fragmentului nu a fost aproape niciodată studiată ca o variabilă de sine stătătoare, deoarece în practică este constrânsă de setul de date — schimbați dimensiunea și, de obicei, ați schimbat și senzorul, regiunea și etichetele, așa că nu puteți spune niciodată cu exactitate care a influențat rezultatul.
Acesta este decalajul pe care SENSERO își propune să îl umple. Aceeași locație este furnizată în opt dimensiuni care partajează același centru, schema de etichetare și data de achiziție, astfel încât singurul lucru care se modifică de la o versiune la alta este cât de mult teren înconjurător include fereastra. Acest lucru transformă dimensiunea fragmentului dintr-un număr arbitrar îngropat într-un fișier de configurare în ceva pe care puteți rula de fapt un experiment controlat.
Ce a arătat în cele din urmă
Așadar, am efectuat acel experiment — iar răspunsurile nu sunt cele evidente „mai mare este mai bine”.
Pentru distincții grosiere (este urban, teren agricol, pădure sau apă?), dimensiunea ferestrei abia a contat: o zonă mică își face deja treaba. Dar pentru clasele fine, mai mult context a ajutat enorm — și într-un mod elocvent. Clasele care au câștigat cel mai mult sunt cele a căror definiție este un model, mai degrabă decât un lucru: „cultură complexă”, „pădure-tufăriș de tranziție”, un mozaic de câmpuri mici. O fereastră îngustă se oprește pe un câmp și nu poate spune cărui model îi aparține; o fereastră largă arată modelul în sine. Dimensiunea fragmentului de care are nevoie un model, se pare, este stabilită mai puțin de senzor decât de cât de fin îi cereți să denumească terenul.
Câștigurile se aplatizează, însă. Peste aproximativ 224–256 de pixeli — în jur de 2 până la 2,5 km lățime — ferestrele mai mari nu mai aduc prea multe beneficii. Și există o asimetrie demnă de știut: un model antrenat pe vederi largi se adaptează bine la cele înguste, dar un model antrenat pe vederi înguste are probleme atunci când i se oferă una largă, deoarece nu a trebuit niciodată să recunoască multe lucruri simultan.
Există o altă constatare ușor de omis, dar care contează mult: modul în care decideți să etichetați terenul — cât de fin îl împărțiți în categorii — modifică rezultatele unui model aproape la fel de mult ca și dimensiunea fragmentului. Numind ceva pur și simplu „pădure”, un model o gestionează ușor; cereți-i să distingă între pădure de foioase, de conifere și mixtă, iar același model pe aceeași imagine pare brusc mult mai slab. Problema este că două studii care raportează precizii foarte diferite s-ar putea să nu fie de fapt în dezacord cu privire la nimic real — s-ar putea să fi sortat același teren în categorii diferite. Așadar, ambele alegeri, dimensiunea fragmentului și modul în care este etichetat terenul, merită să fie declarate în prealabil și comparate echitabil, nu lăsate nespecificate. SENSERO vă permite să le testați pe rând.
Cui se adresează?
Dacă sunteți un student care intră în domeniul observării Pământului, SENSERO este conceput pentru a fi accesibil: un set de date gata făcut, etichetat, cu divizări curate pentru antrenament/testare pe care îl puteți utiliza pentru a învăța cum se comportă modelele de acoperire a terenului — clasice sau viziune-limbaj — pe date geospațiale reale, fără a petrece mai întâi trei luni aranjând plăci brute.
Dacă sunteți un cercetător, este un reper a cărui metodologie o puteți examina, cu linii de bază reproductibile — și, în același timp, un set de date la scară națională pentru o țară care lipsește din principalele colecții europene precum BigEarthNet, ceea ce îl face o țintă gata făcută pentru testarea modului în care modelele antrenate în altă parte se mențin pe teren nou.
Și dacă sunteți pur și simplu curios despre cum fotografiile satelitare devin ceva din care un computer poate învăța, sper că acest lucru vă oferă o privire în culise. Imaginile în sine sunt gratuite pentru oricine le poate descărca, dar transformarea lor într-un set de date pe care oamenii se pot baza necesită multă muncă răbdătoare, în mare parte invizibilă — și despre această muncă este vorba de fapt în SENSERO.
În spatele SENSERO
SENSERO este un efort de echipă al laboratorului GeoSense de la POLITEHNICA București. Am petrecut mult timp construind setul de date; colegii mei au fost esențiali în validarea datelor și a rezultatelor, analizarea acestora și modelarea manuscrisului final. Proiectul a pornit dintr-o necesitate: existau multe imagini frumoase peste România și foarte puține dintre ele într-o formă pe care o puteai pur și simplu utiliza. Construirea corectă a lucrului — eșantionarea densă multi-scară, cele cinci straturi de etichete, divizările spațial oneste, verificările nesfârșite de consistență — a durat mult mai mult decât versiunea care ar fi arătat bine într-un slide. Cred că a meritat.
Setul de date, fluxul de procesare și codul de referință sunt toate lansate deschis sub o licență Creative Commons — datele pe Zenodo, codul pe GitHub — iar lucrarea completă este publicată în Remote Sensing (MDPI).
Dacă ajungeți să-l utilizați, pentru o teză, o lucrare sau doar un experiment de weekend, mi-ar plăcea să aflu ce construiți. Și dacă publicați o lucrare academică bazată pe SENSERO, anunțați-ne: am fi bucuroși să vă listăm lucrarea printre lucrările conexe de pe pagina Zenodo a setului de date, astfel încât și alții să o poată găsi.